Inteligência artificial: de Turing aos agentes
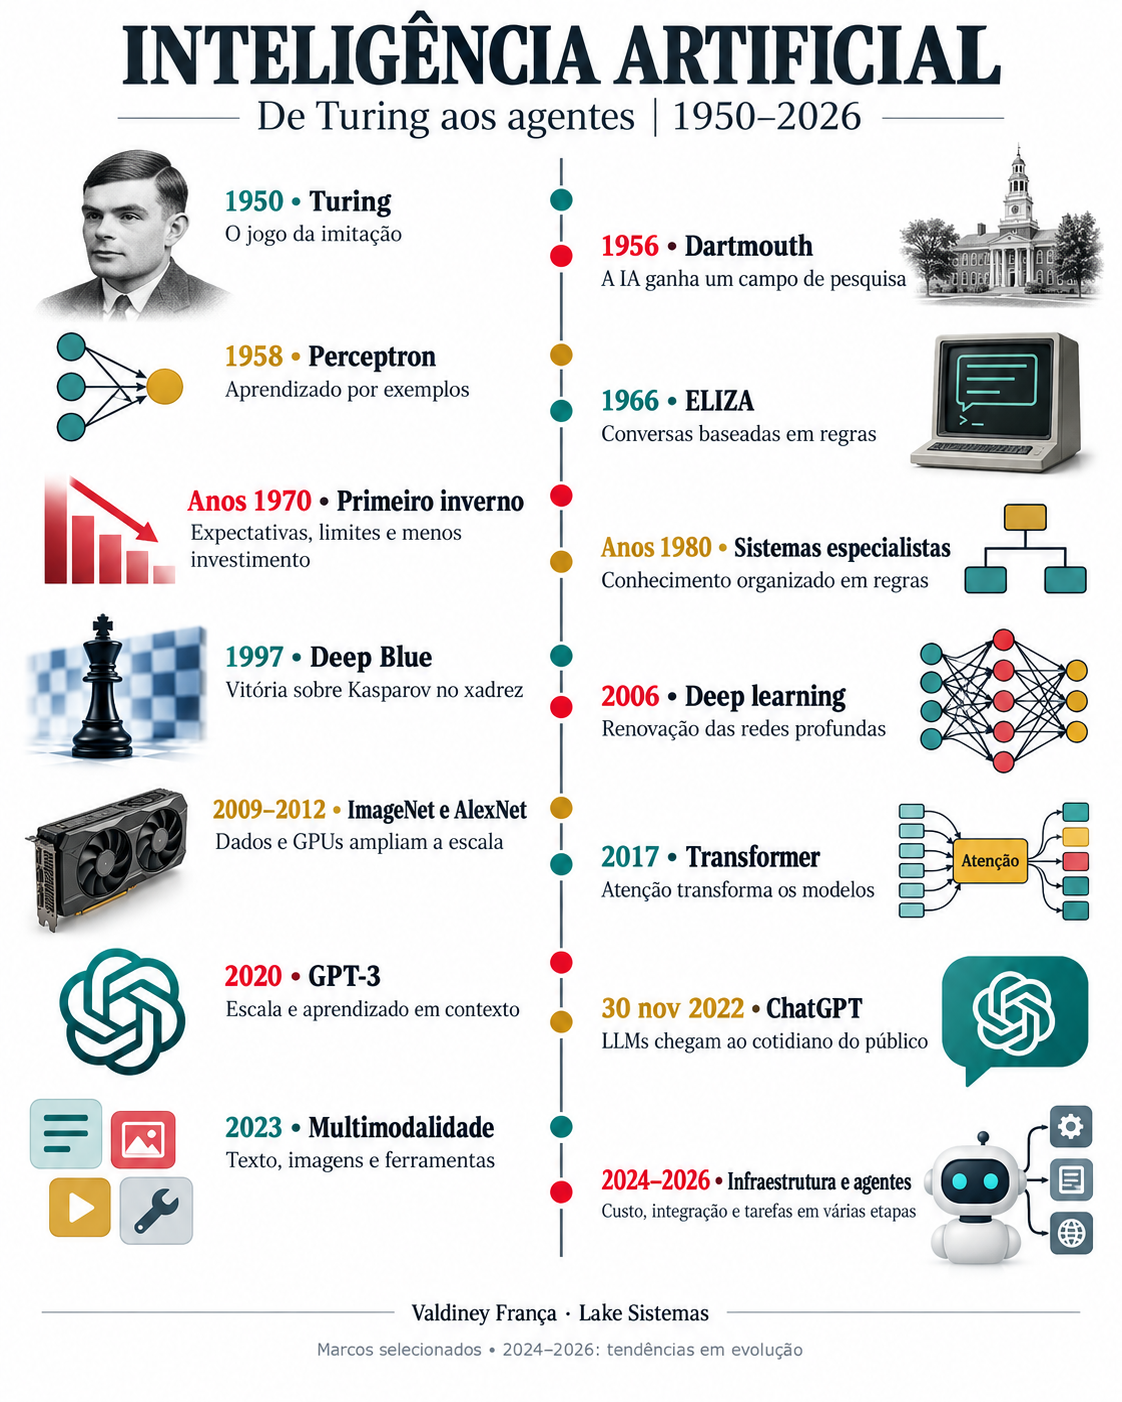
Uma linha do tempo de 1950 a 2026 para entender como ideias, dados, poder computacional e novas arquiteturas construíram o caminho da IA até os agentes de trabalho.
Quando olho para a inteligência artificial que usamos hoje, acho importante voltar um pouco no tempo. A interface de conversa torna tudo muito imediato, mas existe uma história de décadas por trás dela: perguntas sobre inteligência, máquinas que aprendiam caminhos, sistemas de regras, redes neurais e infraestrutura para processar dados em escala.
Organizei essa trajetória em uma linha do tempo porque ela ajuda a enxergar o que mudou em cada etapa. O avanço da IA depende da combinação entre métodos, dados e capacidade de computação. Quando uma dessas partes encontra um limite, a promessa também encontra.
1950 a 1956: a pergunta ganha um campo de pesquisa
Em 1950, Alan Turing propõe discutir a inteligência das máquinas por meio do jogo da imitação. A ideia desloca o debate para um comportamento que pode ser observado em uma interação. Esse teste tem um recorte específico; uma conversa convincente, por si só, não demonstra consciência nem competência em qualquer tarefa.
No início dos anos 1950, Claude Shannon constrói Theseus, um sistema eletromecânico que controla um pequeno rato em um labirinto. O mecanismo registra o caminho encontrado e consegue aproveitá-lo nas tentativas seguintes. Para mim, o interessante aqui é a ligação entre experiência e mudança de comportamento, mesmo em um ambiente muito limitado. A história do Bell Labs apresenta Theseus entre as demonstrações iniciais de aprendizado de máquina.
Em 1956, o encontro de Dartmouth consolida a inteligência artificial como um programa de pesquisa com nome próprio. A proposta havia sido escrita em 1955 por John McCarthy, Marvin Minsky, Nathaniel Rochester e Claude Shannon, para o trabalho do verão seguinte. Esse intervalo importa: a proposta e o encontro são momentos diferentes, como registra o relato de McCarthy sobre Dartmouth.
1958 a 1966: aprender e conversar seguem caminhos diferentes
O perceptron, associado ao trabalho de Frank Rosenblatt e a um marco de divulgação em 1958, mostra uma abordagem de aprendizado por exemplos. Em vez de descrever manualmente todas as regras de classificação, ajustam-se pesos a partir dos dados. As redes simples daquela época tinham limitações importantes, mas ajudaram a estabelecer uma direção que seria retomada e ampliada.
Em paralelo, a IA simbólica explora lógica, busca e representação explícita de conhecimento. Em 1966, ELIZA, de Joseph Weizenbaum, demonstra como regras de transformação de texto podem produzir uma conversa aparentemente natural. Essa experiência continua provocando uma pergunta útil: quanto da impressão de entendimento vem do sistema e quanto vem de quem interpreta a resposta?
Anos 1970 e 1980: promessas, invernos e sistemas especialistas
A partir de meados dos anos 1970, a área atravessa um período de redução de entusiasmo e financiamento, frequentemente chamado de primeiro inverno da IA. As expectativas eram maiores do que os resultados que os sistemas conseguiam entregar. Faltavam recursos computacionais, dados e métodos capazes de lidar com a variedade do mundo real.
Nos anos 1980, os sistemas especialistas levam a IA para aplicações empresariais. Eles codificam conhecimento de um domínio em regras e podem ajudar em tarefas delimitadas, mas exigem manutenção quando o contexto muda. Capturar conhecimento, resolver conflitos entre regras e manter essa base atualizada também tem custo.
Vejo uma lição de engenharia nessa fase: uma demonstração que funciona em condições controladas precisa de muito trabalho para se sustentar em produção. O problema inclui mudanças de contexto, exceções, manutenção e avaliação. Essa preocupação acompanha a IA até hoje.
1997 a 2012: dados e computação mudam a escala
Em 1997, o Deep Blue vence Garry Kasparov em um match de xadrez. Busca, avaliação de posições e hardware especializado produzem um resultado histórico dentro de um domínio formal. A história do Deep Blue, publicada pela IBM, ajuda a entender esse marco sem confundi-lo com os modelos de aprendizado profundo que viriam depois.
Em 2006, trabalhos sobre redes profundas e pré-treinamento ajudam a renovar o interesse pelo deep learning. Um exemplo é o artigo A Fast Learning Algorithm for Deep Belief Nets, de Hinton, Osindero e Teh. Ao longo dos anos seguintes, mais dados e o uso de GPUs tornam o treinamento de redes maiores mais viável.
O ImageNet, apresentado em 2009, oferece uma base de imagens organizada para pesquisa e comparação de modelos. Em 2012, AlexNet mostra resultados expressivos em classificação de imagens usando uma rede convolucional profunda e treinamento em GPU. O projeto ImageNet e o artigo original da AlexNet deixam clara a ligação entre dados, avaliação e processamento.
Essa etapa conversa diretamente com quem trabalha com dados. A qualidade da base, sua organização e a forma de medir os resultados influenciam o que um modelo consegue aprender. O conjunto de dados e o processo de avaliação fazem parte da solução.
2017 a 2022: atenção, modelos de linguagem e IA generativa
Em 2017, o artigo Attention Is All You Need apresenta o Transformer, uma arquitetura baseada em mecanismos de atenção. Na self-attention, as representações dos tokens são calculadas levando em conta relações com outros tokens da sequência. Isso permite modelar dependências e paralelizar etapas do treinamento que, em arquiteturas recorrentes, dependiam de processamento sequencial.
Em 2020, o trabalho Language Models are Few-Shot Learners, sobre GPT-3, mostra ganhos em diversas tarefas com o aumento da escala e exemplos fornecidos no próprio contexto. O artigo também registra dificuldades e limitações. A capacidade de gerar texto útil precisa ser avaliada tarefa por tarefa.
Em 2022, interfaces de conversa e ferramentas de geração de imagens ampliam o contato do público com a IA generativa. A mudança também é de acesso: pessoas passam a experimentar essas capacidades usando linguagem natural. Modelos que antes pareciam distantes do cotidiano passam a participar da escrita, do estudo e do trabalho.
2023 a 2026: multimodalidade, infraestrutura e agentes
Em 2023, modelos multimodais ampliam a combinação entre texto e imagens. O relatório técnico do GPT-4, por exemplo, descreve um modelo que aceita entradas de texto e imagem e produz texto. A integração com ferramentas acrescenta outra dimensão: o sistema pode consultar informações ou executar operações por meio de interfaces externas.
A linha do tempo destaca 2024 como uma etapa em que a infraestrutura ganha ainda mais atenção. Chips, memória, redes, energia e custo de inferência influenciam a viabilidade de treinar e operar modelos. Para quem desenvolve produtos, essa discussão se traduz em latência, orçamento e capacidade de atender usuários.
Em 2025, o documento destaca os agentes de código e de trabalho: sistemas que combinam modelos com ferramentas para conduzir tarefas em várias etapas. Um agente pode escolher uma ação, observar o resultado e ajustar os próximos passos. A discussão da Anthropic sobre agentes distingue essa autonomia dos fluxos em que a sequência de operações é definida previamente.
Para 2026, leio o material como uma discussão sobre a integração da IA ao trabalho e sobre o que ainda precisa ser resolvido. O roadmap de IA da IBM apresenta objetivos sujeitos a mudança, e deve ser entendido nesse contexto. Tendências e planos ajudam a orientar perguntas; a confiabilidade de uma aplicação precisa ser demonstrada no uso concreto.
O que essa história muda na prática?
Minha leitura dessa trajetória é que a utilidade da IA depende de como ela se encaixa em um problema real. Um modelo capaz de responder bem é uma parte do sistema. Para colocá-lo em um fluxo de trabalho, também precisamos definir os dados disponíveis, as ações permitidas e o modo de verificar o resultado.
Quando penso em uma aplicação com IA, estas são algumas perguntas que considero:
- Quais dados e fontes o sistema usa, e como avaliamos sua qualidade?
- Como medimos acertos, erros e resultados que parecem corretos, mas não são?
- Quais ferramentas ele pode executar e quais ações exigem revisão humana?
- Como registramos decisões, investigamos falhas e interrompemos uma execução?
- O ganho entregue compensa o custo, a latência e a manutenção?
De Turing aos agentes, o campo mudou de escala, de métodos e de interfaces. Entender esse percurso me ajuda a olhar para a IA com curiosidade e critério. Quero saber o que ela consegue fazer, em quais condições funciona e como construir uma solução cujo resultado possa ser conferido.